Поделиться:
Почему новая функция ломает старые: как архитектура ПО влияет на доработки
Новая функция работает, а после обновления ломаются отчёты и интеграции. Разбираем, откуда берутся скрытые зависимости и технический долг, почему тесты не всегда ловят такие ошибки и когда достаточно точечных исправлений, а когда нужен технический аудит.
11.11.2026
Обновлено: 11.11.2026
Содержание
Почему после доработки ПО ломаются старые функции: с чего начать разбираться
Добавить новый статус заказа, изменить расчёт стоимости доставки или подключить ещё одну CRM — на первый взгляд, обычные задачи для команды разработки. Но иногда после таких обновлений перестают формироваться отчёты, возникают ошибки в интеграциях или нарушаются процессы, которые раньше работали без сбоев.
При этом новая функция может работать совершенно правильно. Проблема обнаруживается в другом месте системы, которое разработчики даже не планировали изменять.
Подобные ситуации часто связывают с ошибками программирования или недостаточным тестированием. Однако причина может быть глубже — в архитектуре программного обеспечения, накопленных зависимостях и технических решениях, которые принимались на протяжении нескольких лет.
Разбираемся, почему небольшие доработки иногда приводят к серьёзным сбоям, как архитектура влияет на стоимость развития ПО и в каких случаях технический аудит помогает избежать полной переработки системы.
Почему изменение одной функции затрагивает всю систему
Представим корпоративную систему управления заказами. В ней есть три статуса: «Новый», «В работе» и «Завершён». Компания меняет процесс отгрузки и просит разработчиков добавить ещё один — «Частично отгружен».
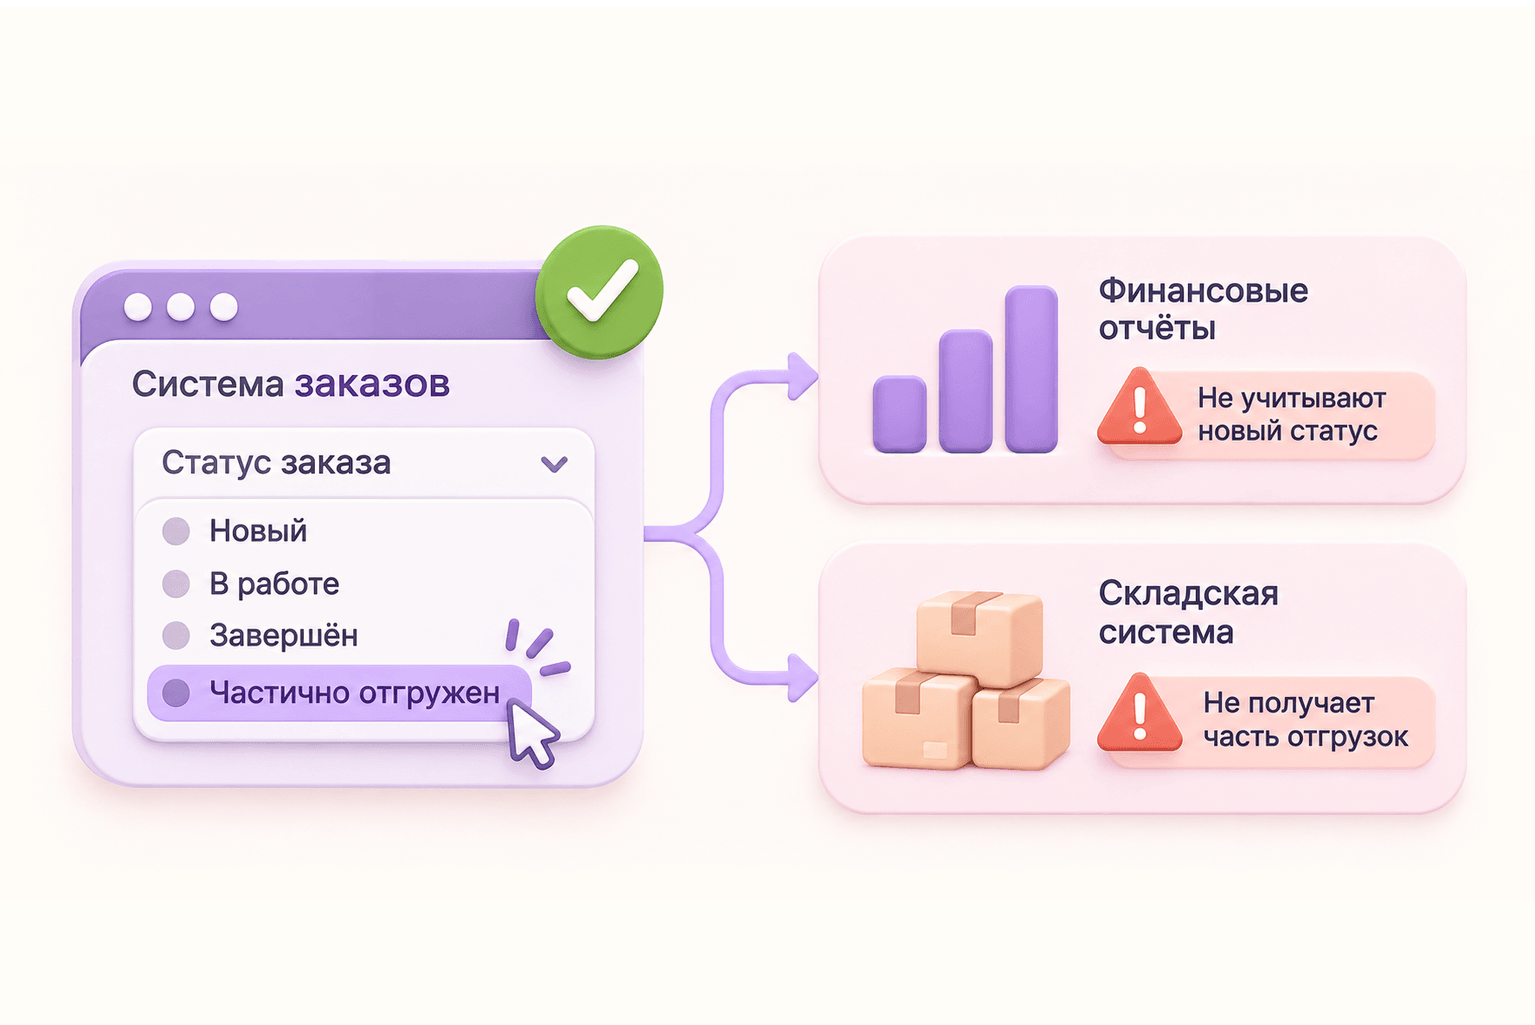
Задача кажется простой. Нужно добавить новое значение, предусмотреть его отображение в интерфейсе и сохранить в базе данных.
После обновления сотрудники могут выбирать новый статус. Однако через несколько дней бухгалтерия замечает расхождения в финансовых отчётах. Заказы с новым статусом не учитываются в расчётах, а складская система не получает информацию о части отгрузок.
Новая функция работает, но связанные процессы — нет.
Причина в том, что статус заказа используется не только в интерфейсе. От него могут зависеть правила расчёта выручки, резервирования товаров, формирования документов и передачи информации во внешние системы. Если каждый из этих компонентов самостоятельно интерпретирует статусы, добавление нового значения требует изменений сразу в нескольких местах.
Разработчики изменили одну функцию, но фактически затронули несколько бизнес-процессов.
Это условный пример, но он хорошо показывает характерную проблему действующего ПО: последствия изменения определяются не только самим изменением, но и количеством зависимых от него компонентов.
Скрытые зависимости между компонентами
По мере развития системы в ней появляются новые функции, интеграции и правила обработки данных. Некоторые компоненты начинают использовать общие таблицы базы данных, другие обращаются непосредственно к внутренней логике соседних модулей.
Пока система работает в привычных условиях, такие зависимости могут оставаться незаметными.
Проблемы начинаются при изменениях. Например, разработчики разделяют стоимость доставки на перевозку, упаковку и страхование. В интерфейсе всё отображается корректно, но старый модуль отчётности по-прежнему ожидает одно поле с итоговой стоимостью.
Похожая ситуация возможна при изменении API. Если новая версия сервиса передаёт данные в другом формате, внешние системы, использующие прежний формат, могут перестать их обрабатывать.
Ошибки такого рода особенно сложно обнаружить, когда зависимости не задокументированы. Команде приходится восстанавливать связи между компонентами уже в процессе разработки или после возникновения сбоя.
Поэтому перед изменением существующей системы недостаточно разобраться только в том участке кода, который отвечает за новую функцию. Необходимо понимать, где ещё используются эти данные и какие процессы зависят от их структуры или значения.
Как архитектура влияет на стоимость доработок
Архитектура программного обеспечения определяет, как система разделена на компоненты, какие задачи они выполняют и каким образом взаимодействуют между собой.
От этого зависит не только производительность или устойчивость к нагрузкам. Архитектура напрямую влияет на объём работы, необходимый для добавления новых функций.
Представим две системы с одинаковыми возможностями.
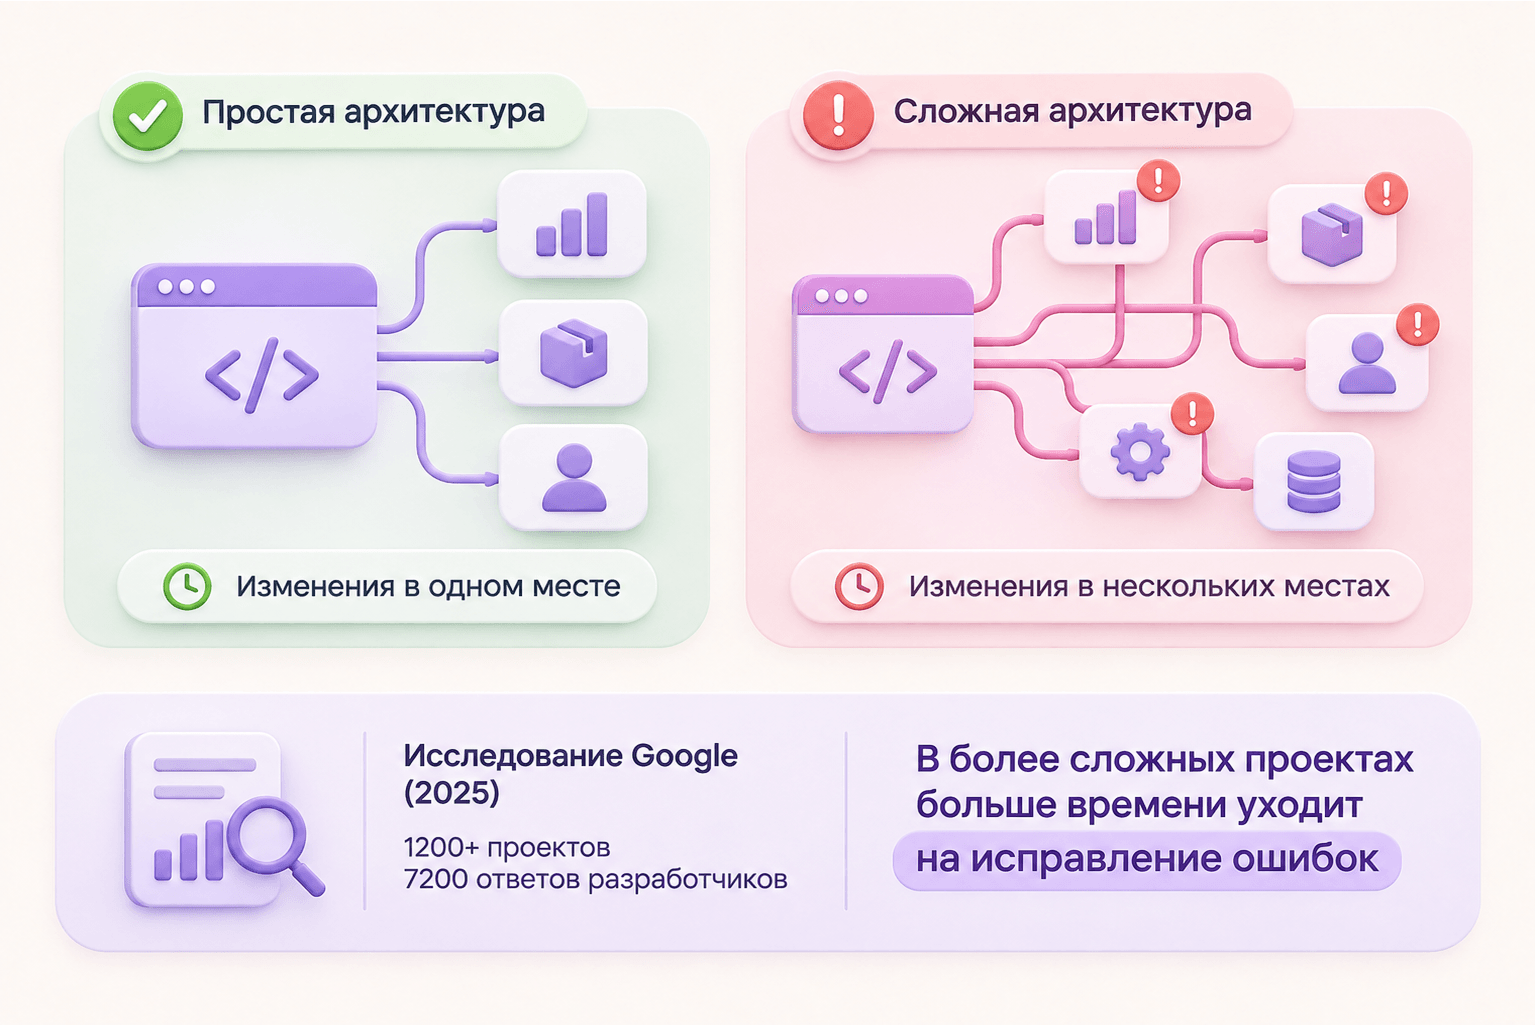
В первой обработка заказов сосредоточена в отдельном компоненте. Отчётность, склад и личный кабинет получают сведения через согласованные интерфейсы. Если меняются правила обработки статусов, основную логику можно скорректировать в одном месте.
Во второй системе те же правила продублированы в нескольких модулях. Каждый из них самостоятельно проверяет допустимые статусы, рассчитывает показатели или определяет дальнейшее действие.
В результате одна и та же задача требует разного объёма работ. Во второй системе разработчикам нужно найти все места, где используется прежняя логика, внести изменения и проверить, не возникли ли противоречия между компонентами.
Чем больше подобных зависимостей, тем труднее оценивать сроки и последствия доработок.
В 2025 году исследователи Google проанализировали более 1200 проектов на C++ и Java, а также 7200 ответов разработчиков. Авторы сопоставили архитектурную сложность проектов с характером изменений в коде и оценками специалистов.
Исследование выявило закономерность: в проектах с более сложной архитектурой большая доля написанного кода приходилась на исправление ошибок, а не на разработку новых функций.
Речь идёт о статистической связи, а не о доказательстве того, что сложная архитектура неизбежно приводит к дефектам. Тем не менее результаты хорошо иллюстрируют проблему сопровождения крупных систем: разработка нового функционала начинает конкурировать за ресурсы с устранением последствий предыдущих изменений.
При этом сложность архитектуры сама по себе не означает низкое качество ПО. Крупной системе с большим количеством бизнес-процессов объективно требуется более сложное устройство, чем небольшому приложению.
Вопрос в другом: насколько эта сложность оправданна и можно ли изменять отдельные компоненты, не затрагивая всю систему.
Хорошая архитектура не обязательно предполагает множество независимых сервисов. Иногда монолитное приложение с понятными границами между модулями оказывается удобнее в сопровождении, чем распределённая система с десятками тесно связанных сервисов.
Главный критерий — не количество компонентов, а предсказуемость изменений.
Технический долг: почему доработки со временем становятся дороже
Архитектурные проблемы редко появляются в один момент. Чаще они накапливаются постепенно, по мере развития продукта.
Допустим, компании необходимо срочно запустить новую функцию. Разработчики понимают, что для правильной реализации потребуется переработать общий механизм обработки заказов. Но сроки ограничены, поэтому они добавляют отдельное условие в существующий модуль.
Такое решение может быть вполне обоснованным. Функция появляется вовремя, бизнес продолжает работать, а масштабная переработка откладывается.
Сложности возникают позже, когда аналогичные временные решения начинают накапливаться.
При следующей доработке команда обнаруживает, что правила обработки заказов находятся в разных частях программы, некоторые условия дублируются, а документация не отражает реального устройства системы.
Прежде чем реализовать новую задачу, разработчикам приходится разбираться с предыдущими решениями.
Так формируется технический долг — последствия компромиссов, которые позволяют сократить затраты на разработку сейчас, но могут увеличить стоимость изменений в будущем.
Важно, что технический долг не всегда связан с ошибками или низким качеством разработки. Иногда компания сознательно принимает его ради быстрого запуска продукта. Проблемой он становится тогда, когда временные решения остаются без контроля и начинают ограничивать развитие системы.
Почему технический долг нельзя измерить количеством ошибок
Дефект и технический долг — не одно и то же.
Если программа неправильно рассчитывает стоимость заказа, это дефект. Если расчёт работает корректно, но его правила продублированы в нескольких модулях и любое изменение требует согласованной переработки всех копий, это возможный признак технического долга.
Система может годами работать стабильно и при этом быть сложной в сопровождении.
В исследовании, опубликованном в Information and Software Technology в 2025 году, учёные изучили, как архитектурные недостатки связаны с необходимостью совместно изменять разные файлы программы.
Они обнаружили, что пары файлов с определёнными архитектурными проблемами чаще изменялись вместе, чем пары без таких признаков.
Результаты относятся к исследованным типам архитектурных недостатков и не позволяют делать выводы обо всех разновидностях технического долга. Однако они показывают, как взаимосвязи в коде могут увеличивать объём работ при сопровождении системы.
Например, вместо изменения одного модуля разработчику приходится корректировать ещё несколько зависимых частей. Каждая дополнительная правка требует проверки, увеличивает время разработки и создаёт новые возможности для ошибок.
Но из этого не следует, что нужно срочно устранять весь накопленный технический долг.
Если компонент стабильно работает, редко изменяется и не мешает развитию продукта, его переработка может не принести экономической пользы. Гораздо важнее определить, какие технические ограничения действительно влияют на стоимость разработки, устойчивость системы и возможность реализации новых бизнес-задач.
Почему тестирование не гарантирует отсутствие ошибок после обновления
После сбоя в рабочей системе возникает закономерный вопрос: почему ошибку не обнаружили до выпуска обновления?
Одна из причин — недостаточное покрытие связанных сценариев.
Когда команда добавляет новый статус заказа, она может проверить, что значение сохраняется в базе данных, отображается в интерфейсе и правильно изменяется пользователем.
Но это не гарантирует, что статус корректно обрабатывают финансовая отчётность, складской учёт и внешние сервисы.
В таком случае новая функция проходит проверку, хотя в системе уже присутствует ошибка.
Подобные нарушения называют регрессионными: изменения в программе приводят к тому, что ранее работавшие функции начинают вести себя неправильно.
Для их обнаружения используют регрессионное тестирование — повторную проверку существующих сценариев после доработок.
Почему нельзя проверять абсолютно всё
По мере роста системы увеличивается и количество проверок. В крупных проектах их могут быть сотни тысяч, а выполнение полного набора после каждого изменения становится слишком затратным.
В исследовании Google 2026 года рассматривались десять критически важных библиотек, для каждой из которых существовало в среднем около 220 тысяч тестов.
Исследователи предложили выбирать проверки с учётом зависимостей в коде. В эксперименте запуск 2000 тестов на изменение, составлявший около 0,9% полной стоимости выполнения набора, позволял обнаруживать регрессии для 40% изменений, действительно приводивших к сбоям.

Эти результаты относятся к конкретному методу и инфраструктуре Google. Они не означают, что запуск небольшой части тестов обеспечит аналогичную эффективность в любой системе.
Значение исследования в другом: даже при наличии развитой автоматизации необходимо решать, какие проверки запускать после конкретного изменения.
Если команда понимает зависимости между компонентами, она может точнее определить потенциально затронутые сценарии. Если таких знаний нет, часть рисков остаётся за пределами тестирования.
Почему больше тестов не всегда означает более надёжную систему
Увеличение количества проверок тоже имеет свою цену. Автоматические тесты необходимо разрабатывать, обновлять при изменении функциональности, поддерживать и анализировать результаты их выполнения.
В исследовании Journal of Systems and Software 2025 года учёные изучили опыт специалистов шести крупных компаний. Работа включала совместные семинары и фокус-группы, посвящённые практике тестирования.
Участники отмечали, что рост количества тестов увеличивает затраты на их сопровождение и выполнение. Поэтому автоматические проверки необходимо сочетать с другими способами обеспечения качества программного обеспечения.
Есть и дополнительная проблема — нестабильность самих тестов.
В исследовании IEEE Transactions on Software Engineering 2026 года авторы проанализировали 8,8 млрд запусков тестов в четырёх крупных промышленных проектах.
От 9,8 до 16,3% неуспешных запусков проверочных конвейеров были связаны с нестабильными тестами, которые не распознавались стандартными механизмами обнаружения.
Это не доля ошибок в продукте. Речь о случаях, когда проверка завершается неудачей из-за условий выполнения, тестовой инфраструктуры или других факторов, не обязательно связанных с дефектом программы.
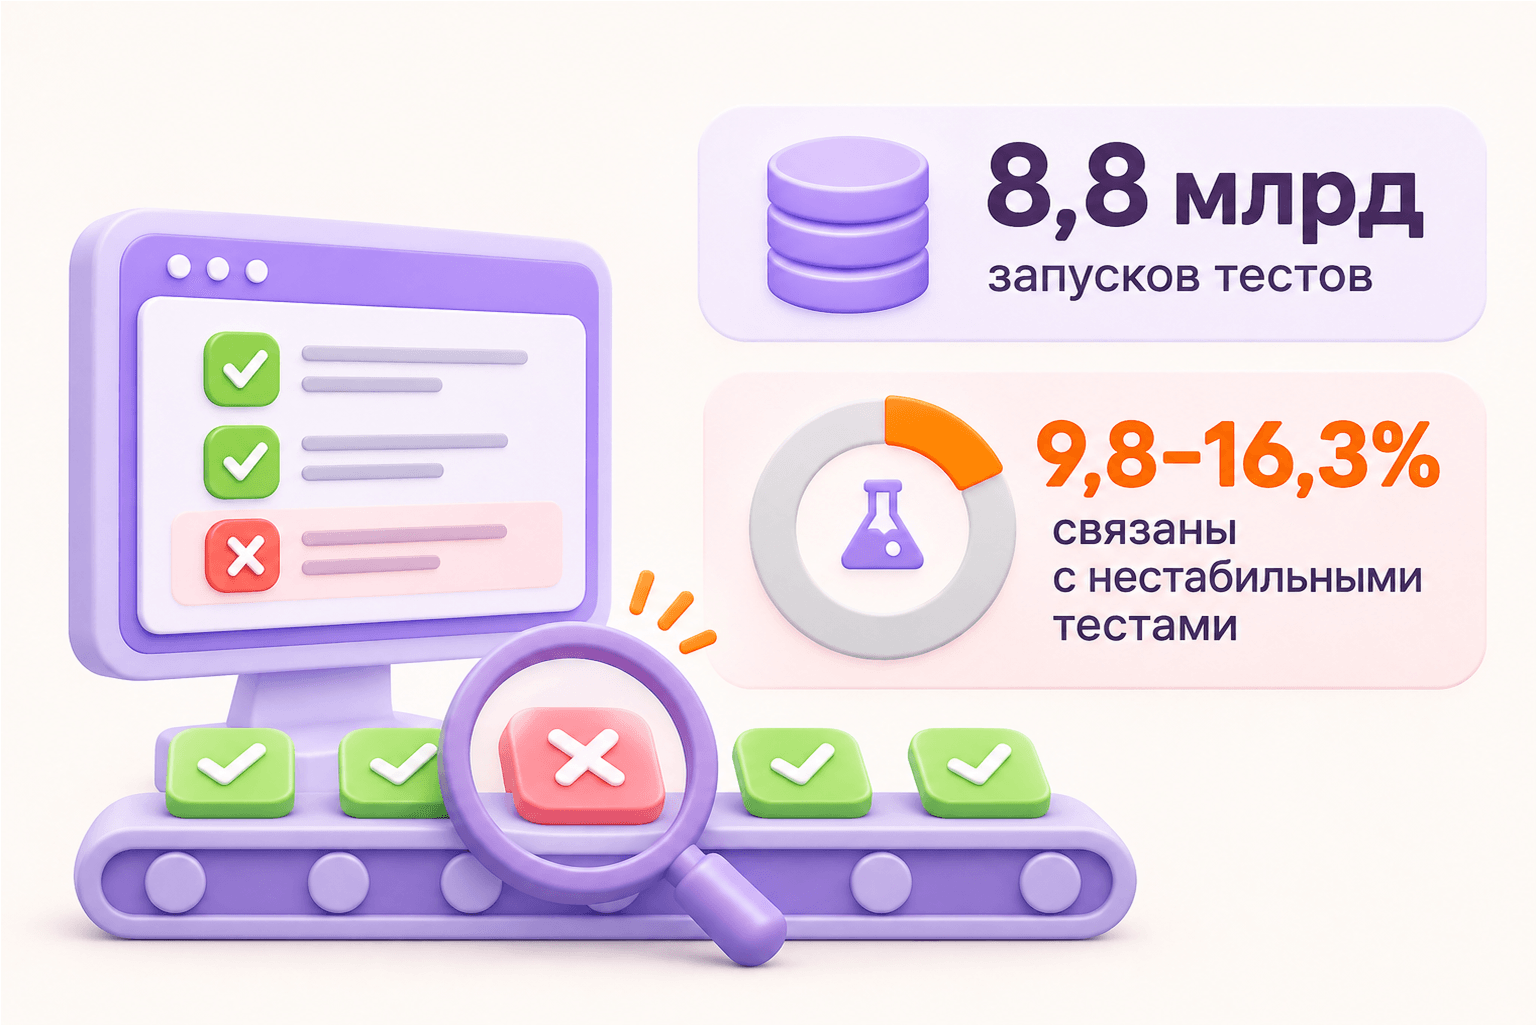
Такие сбои создают дополнительную нагрузку: разработчикам приходится выяснять, действительно ли обновление нарушило работу системы или ошиблась сама проверка.
Поэтому надёжное тестирование требует не просто большого количества сценариев. Нужны актуальные проверки критичных процессов, понимание архитектурных зависимостей и стабильная тестовая инфраструктура.
Когда проблемы с доработками требуют технического аудита
Не каждое неудачное обновление свидетельствует о проблемах архитектуры. Сбой может возникнуть из-за ошибки в требованиях, некорректной конфигурации, недоступности внешнего сервиса или отдельного дефекта.
Но если похожие ситуации повторяются, важно разобраться не только с очередной ошибкой, но и с условиями, в которых она возникла.
Именно для этого проводят технический аудит ПО — обследование архитектуры, кода, инфраструктуры, интеграций и процессов разработки.
Его задача не в том, чтобы найти как можно больше замечаний. Необходимо установить, что ограничивает развитие системы, создаёт риски для бизнеса и увеличивает стоимость изменений.
Какие признаки требуют внимания
После обновлений перестают работать старые функции. Если подобные ситуации происходят регулярно, стоит проверить связи между компонентами, дублирование бизнес-логики и полноту регрессионного тестирования.
Небольшие доработки занимают непропорционально много времени. Возможно, разработчикам приходится изменять несколько модулей ради одной функции. Но причина может заключаться и в организации работы: неясных требованиях, длительных согласованиях или отсутствии документации.
Команда не может заранее оценить последствия изменений. Если разработчики затрудняются определить, какие процессы затронет доработка, это может говорить о недостаточно изученных зависимостях или плохо документированной архитектуре.
Ошибки регулярно возвращаются. Команда исправляет отдельные проявления проблемы, не устраняя её источник. Например, корректирует расчёт в одном отчёте, хотя аналогичная логика используется в других модулях.
Интеграции работают нестабильно. Данные передаются с задержками, теряются или требуют ручной проверки. В таком случае важно оценить обработку ошибок, контроль обмена, повторные попытки отправки и согласованность форматов.
Обновления приходится часто откатывать. Причина может быть не только в устройстве приложения, но и в процедурах выпуска, миграциях базы данных, конфигурации или отсутствии мониторинга.
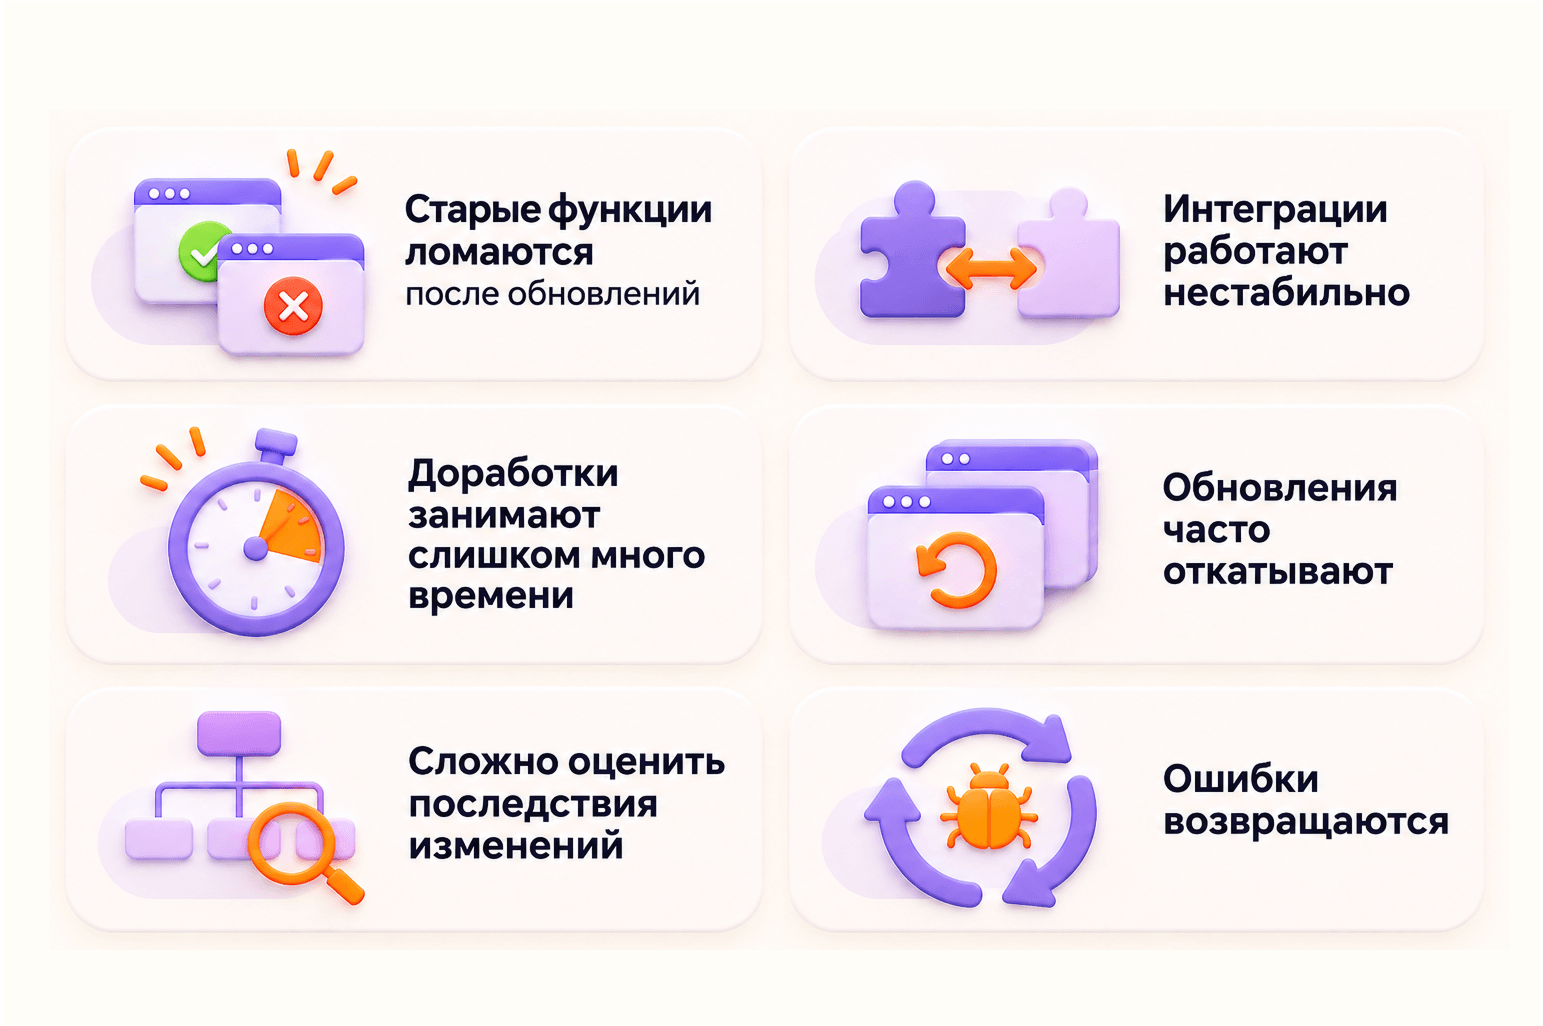
Каждый из этих признаков по отдельности ещё не доказывает наличие архитектурной проблемы. Но их сочетание — веская причина провести обследование, прежде чем продолжать масштабные доработки.
Что бизнес должен получить по итогам аудита
Отчёт о техническом состоянии системы полезен только тогда, когда на его основе можно принять решение.
Недостаточно перечислить устаревшие библиотеки, сложные участки кода и нарушения инженерных практик. Необходимо объяснить, какие последствия они создают для действующего продукта и как влияют на будущие изменения.
По результатам аудита компания должна понимать:
- Какие компоненты создают наибольшие технические и бизнес-риски.
- Какие зависимости мешают быстро и безопасно развивать систему.
- Какие проблемы можно устранить локально, а какие требуют изменения архитектуры.
- Какие проверки, инструменты мониторинга и процедуры выпуска необходимо доработать.
- В какой последовательности выполнять изменения, чтобы получить результат без неоправданных затрат.
На основе этих данных формируется план работ с приоритетами, оценкой трудоёмкости и рисков.
Такой подход позволяет избежать двух крайностей: бесконечно исправлять отдельные ошибки, не устраняя их причины, или начинать полную переработку системы без понимания её реального состояния.
Исправлять, модернизировать или переписывать систему
Когда сопровождение программного обеспечения становится дорогим, у бизнеса нередко возникает идея разработать новую систему вместо существующей.
На первый взгляд, это логично: проще создать новую архитектуру, чем разбираться в чужом коде, накопленных зависимостях и устаревших решениях.
Но у такого подхода есть существенные риски.
За годы эксплуатации система накапливает множество бизнес-правил: особенности расчётов, исключения, настройки интеграций, сценарии обработки ошибок и нестандартные требования пользователей. Часть этих правил может существовать только в коде и фактических рабочих процессах.
При полной переработке их приходится выявлять и реализовывать заново. В противном случае новая программа может оказаться технически современной, но не обеспечивать работу привычных бизнес-процессов.
Поэтому решение зависит от масштаба и характера выявленных проблем.
|
Подход |
Когда подходит |
Что необходимо учитывать |
|
Локальное исправление |
Проблема ограничена отдельным компонентом |
Исправление должно устранять причину, а не только проявление ошибки |
|
Поэтапная модернизация |
Система решает задачи бизнеса, но отдельные компоненты мешают развитию |
Потребуется поддерживать совместную работу старых и новых решений |
|
Полная переработка |
Текущая платформа принципиально не соответствует требованиям, а дальнейшее развитие экономически нецелесообразно |
Возможны потери бизнес-логики, сложности переноса данных и новые дефекты |
Почему рефакторинг не всегда помогает
Один из способов улучшить существующую программу — рефакторинг, то есть изменение внутренней структуры кода без намеренного изменения его поведения.
Например, можно объединить дублирующиеся правила обработки заказов или разделить слишком крупный модуль на несколько частей.
Однако рефакторинг сам по себе не гарантирует решения архитектурных проблем.
В исследовании ACM/IEEE ESEM 2025 года авторы проанализировали 212 664 изменения в 87 открытых проектах на Java. Они обнаружили, что большинство зафиксированных операций рефакторинга не сопровождалось устранением выявленных признаков проблемного кода. При этом архитектурные недостатки сохранялись дольше локальных проблем реализации.
Эти результаты не означают, что рефакторинг бесполезен. Его проводят по разным причинам: для повышения читаемости, упрощения разработки или подготовки к новым функциям.
Но если цель заключается именно в устранении архитектурного ограничения, сначала необходимо выявить его причину, а затем проверить, действительно ли выбранные изменения её устранили.
Иначе команда рискует потратить время на улучшение отдельных участков кода, сохранив проблемы во взаимодействии компонентов.
Как работает поэтапная модернизация
Полностью заменять систему необязательно. Часто её можно развивать постепенно, сохраняя работоспособные компоненты.
Один из известных подходов описал Мартин Фаулер — Strangler Fig Application.
Его суть заключается в последовательной замене отдельных функций действующей системы новыми компонентами.
Например, сначала можно выделить правила обработки заказов в отдельный модуль и перевести на него основные операции. Затем обновить отчётность и интеграции, которые используют эти данные.
При этом пользователи продолжают работать с системой, а команда последовательно сокращает зависимость от старой реализации.
Такой подход не исключает сложностей. На переходном этапе необходимо поддерживать взаимодействие старых и новых компонентов, обеспечивать согласованность данных и контролировать переключение процессов.
Однако он позволяет распределить затраты и риски во времени, не связывая весь результат с единовременным запуском новой системы.
Полная переработка оправданна в тех случаях, когда ограничения существующей платформы невозможно устранить разумными затратами или её дальнейшая эксплуатация создаёт неприемлемые риски.
Принять обоснованное решение без предварительного обследования сложно: необходимо сопоставить не только стоимость разработки, но и риски переноса данных, сохранения бизнес-логики и поддержки действующих процессов.
Как снизить риск ошибок при следующих доработках
Самый эффективный способ предотвратить часть проблем — оценивать последствия изменений до начала разработки.
Вернёмся к примеру с новым статусом заказа. Перед реализацией необходимо выяснить, какие компоненты используют статусы и как они должны обрабатывать новое значение.
Для этого команда анализирует связанные модули, структуру данных, бизнес-правила и интеграции. На основе полученной информации определяет, какие сценарии потребуется проверить.
Например, недостаточно убедиться, что статус «Частично отгружен» появился в интерфейсе. Нужно проверить его влияние на расчёт выручки, формирование документов, списание остатков и передачу данных в CRM.
Особенно внимательно следует относиться к изменениям структуры базы данных и контрактов взаимодействия между сервисами. Такие доработки способны затронуть компоненты, которые непосредственно не участвовали в разработке новой функции.
Для критичных систем также полезен постепенный выпуск обновлений. Новую реализацию можно сначала включить для ограниченной группы пользователей или небольшой доли операций, проверить результаты и только после этого распространить на всю систему.
После выпуска важно контролировать не только технические ошибки, но и бизнес-показатели: количество неуспешных операций, расхождения в отчётности, задержки обмена данными и отклонения в работе ключевых процессов.
Отдельно стоит предусмотреть возможность отката. При этом возврат предыдущей версии приложения не всегда отменяет изменения в данных, поэтому способы восстановления нужно продумывать заранее.
Как понять, что процесс разработки стал стабильнее
Количество выпущенных функций и соблюдение сроков не дают полной картины качества разработки.
Команда может быстро выпускать обновления, но затем тратить значительную часть времени на устранение возникших ошибок.
Для оценки устойчивости изменений можно использовать показатели методологии DORA, которая рассматривает как скорость поставки программного обеспечения, так и её стабильность.
В частности, полезно отслеживать долю изменений, требующих вмешательства после выпуска, количество незапланированных исправлений и время восстановления после неудачных обновлений.
В сочетании с данными о длительности разработки эти показатели помогают понять, становится ли развитие системы более предсказуемым.
Если новые функции выпускаются регулярно, количество сбоев не увеличивается, а время восстановления сокращается, это говорит об улучшении управляемости изменений.
Цель не в том, чтобы полностью исключить ошибки. Для сложных программных систем такая гарантия нереалистична. Важнее снижать вероятность серьёзных сбоев и ограничивать их последствия для пользователей и бизнеса.
Как АЙТИФОКС модернизировала инвестиционную платформу без полной переработки
Похожая задача по работе с существующей архитектурой возникла у АЙТИФОКС при модернизации инвестиционной онлайн-платформы.
Заказчик обратился после работы двух предыдущих команд разработки. Платформа продолжала функционировать, но её развитие осложняли проблемы с производительностью, нестабильная работа интеграций и отсутствие технической документации.
Страницы реестра загружались по 20–60 секунд. Часть информации из внешних источников не поступала, а некоторые операции приходилось выполнять вручную.
При этом систему необходимо было подготовить к отраслевому мероприятию за полтора месяца.
Полная переработка платформы в таких условиях не соответствовала срокам и создавала дополнительные риски. Поэтому команда начала с обследования существующего решения.
Что обнаружили при аудите
В течение первых двух недель разработчики изучали архитектуру, код, запросы к базе данных, интеграции и инфраструктуру.
Одной из причин низкой производительности оказалась избыточная загрузка данных. При открытии страницы система запрашивала значительно больше информации, чем требовалось пользователю.
Например, вместе с карточкой компании могли загружаться сведения о сотрудниках, пользователях, сделках и контрактах.
Дополнительную нагрузку создавал поиск на Elasticsearch.
Проблемы были и в интеграциях. Обработка ошибок работала недостаточно надёжно, ожидание ответов внешних сервисов не всегда контролировалось, а прозрачного механизма отслеживания обмена данными не хватало.
Это означало, что простое увеличение серверных ресурсов не решило бы всех проблем. Требовалось изменить способ получения и обработки информации.
Как модернизировали систему
Первым шагом стало внедрение кэширования. Это позволило ускорить работу ключевых страниц до проведения масштабной оптимизации и подготовить платформу к мероприятию.
После стабилизации команда приступила к последовательной переработке проблемных компонентов.
Разработчики оптимизировали запросы к базе данных и новую версию API, чтобы система загружала только сведения, необходимые для конкретной операции.
В пользовательской части полнотекстовый поиск PostgreSQL заменил Elasticsearch. При этом Elasticsearch сохранили для административных задач, где он продолжал выполнять свою функцию.
Для более контролируемого обмена данными с внешними сервисами внедрили Kafka.
Одновременно создали тестовую среду, настроили мониторинг ошибок и автоматизированное развёртывание обновлений.
Результат
Время загрузки ключевых страниц сократилось с 20–60 секунд до 200–500 миллисекунд.
Платформа получила более производительную архитектуру, управляемый обмен данными и инструменты для дальнейшего развития.
Этот проект не связан напрямую с ситуацией, когда одна новая функция нарушает работу старой. Он показывает более широкий принцип: серьёзные проблемы действующей системы не обязательно требуют её полной замены.
Сначала команда установила причины ограничений, затем устранила наиболее критичные проблемы и постепенно модернизировала отдельные компоненты, сохранив рабочую основу продукта.
Подробнее: кейс АЙТИФОКС о модернизации инвестиционной платформы.
Что делать, если доработки постоянно приводят к новым ошибкам
Если каждая новая функция требует всё больше времени, а после обновлений регулярно возникают сбои, причина может заключаться не в сложности отдельных задач, а в устройстве программного обеспечения.
Накопленные зависимости, дублирование бизнес-логики, технический долг и недостаточный контроль изменений постепенно делают развитие системы менее предсказуемым.
При этом проблему редко удаётся решить простым увеличением команды или количества тестов. Дополнительные ресурсы помогают выполнять больше работы, но не устраняют архитектурные ограничения.
Полная переработка системы тоже не всегда оправданна. Вместе со старым кодом бизнес рискует потерять накопленные правила и получить новые проблемы при переносе данных и процессов.
Поэтому разумнее начинать с обследования: определить, какие компоненты создают основные риски, где возникают скрытые зависимости и что действительно мешает развитию продукта.
После технического аудита можно выбрать подходящий способ изменений — от локального исправления до поэтапной модернизации архитектуры.
Главная задача — не сделать код идеальным, а обеспечить возможность развивать систему без непропорционального роста затрат и рисков.
АЙТИФОКС проводит технический аудит, дорабатывает и модернизирует действующее ПО. Мы изучаем существующую архитектуру, находим ограничения и предлагаем изменения с учётом бизнес-процессов, сроков и стоимости сопровождения.
Часто задаваемые вопросы
[ 1 ]
Почему после обновления программы перестают работать старые функции?
Изменения могут затрагивать общие данные, бизнес-логику и интеграции. Если связанные компоненты продолжают работать по прежним правилам, возникают регрессионные ошибки, даже когда новая функция реализована корректно.
[ 2 ]
Как понять, что проблема связана с архитектурой ПО?
На это могут указывать повторяющиеся сбои после доработок, необходимость изменять множество компонентов ради одной функции и сложности с оценкой последствий обновлений. Установить точную причину помогает техническое обследование.
[ 3 ]
Когда нужен технический аудит программного обеспечения?
Когда стоимость сопровождения растёт, обновления регулярно вызывают ошибки, интеграции работают нестабильно или команда не может оценить последствия изменений. Аудит также полезен перед масштабной модернизацией или передачей системы новому подрядчику.
[ 4 ]
Можно ли модернизировать систему без полного переписывания?
Да. Если основная часть системы продолжает выполнять задачи бизнеса, проблемные компоненты можно оптимизировать или постепенно заменить. Решение зависит от состояния архитектуры, стоимости изменений и рисков для действующих процессов.
[ 5 ]
Чем рефакторинг отличается от модернизации ПО?
Рефакторинг меняет внутреннюю структуру кода без намеренного изменения его поведения. Модернизация охватывает более широкий круг задач: изменение архитектуры, обновление технологий, переработку интеграций, инфраструктуры и механизмов обработки данных.
О разработке, технологиях и бизнесе
#high-load
Когда бизнесу нужна высоконагруженная архитектура и как разработать такой сервис

#мобильнаяразработка
Кому на самом деле принадлежат данные ваших клиентов в сервисах доставки?

#кроссплатформеннаяразработка
#мобильнаяразработка
#нативнаяразработка
Что мы говорим клиенту, когда он просит нативную разработку?
Оставить заявку
Напишите на email
hello@itfox-web.com
Позвоните по номеру
+7 (928) 854-24-62
или расскажите о проекте оставив заявку
Поможем, даже если у вас нет технического задания
Определим стоимость разработки
Предложим способы снижения затрат на проект без потери качества
Дадим рекомендации по повышению эффективности вашего проекта